1. 왜 Next.js에서 Worker가 필요한가
작성일:2025.05.26|수정일:2026.11.14|조회수:2
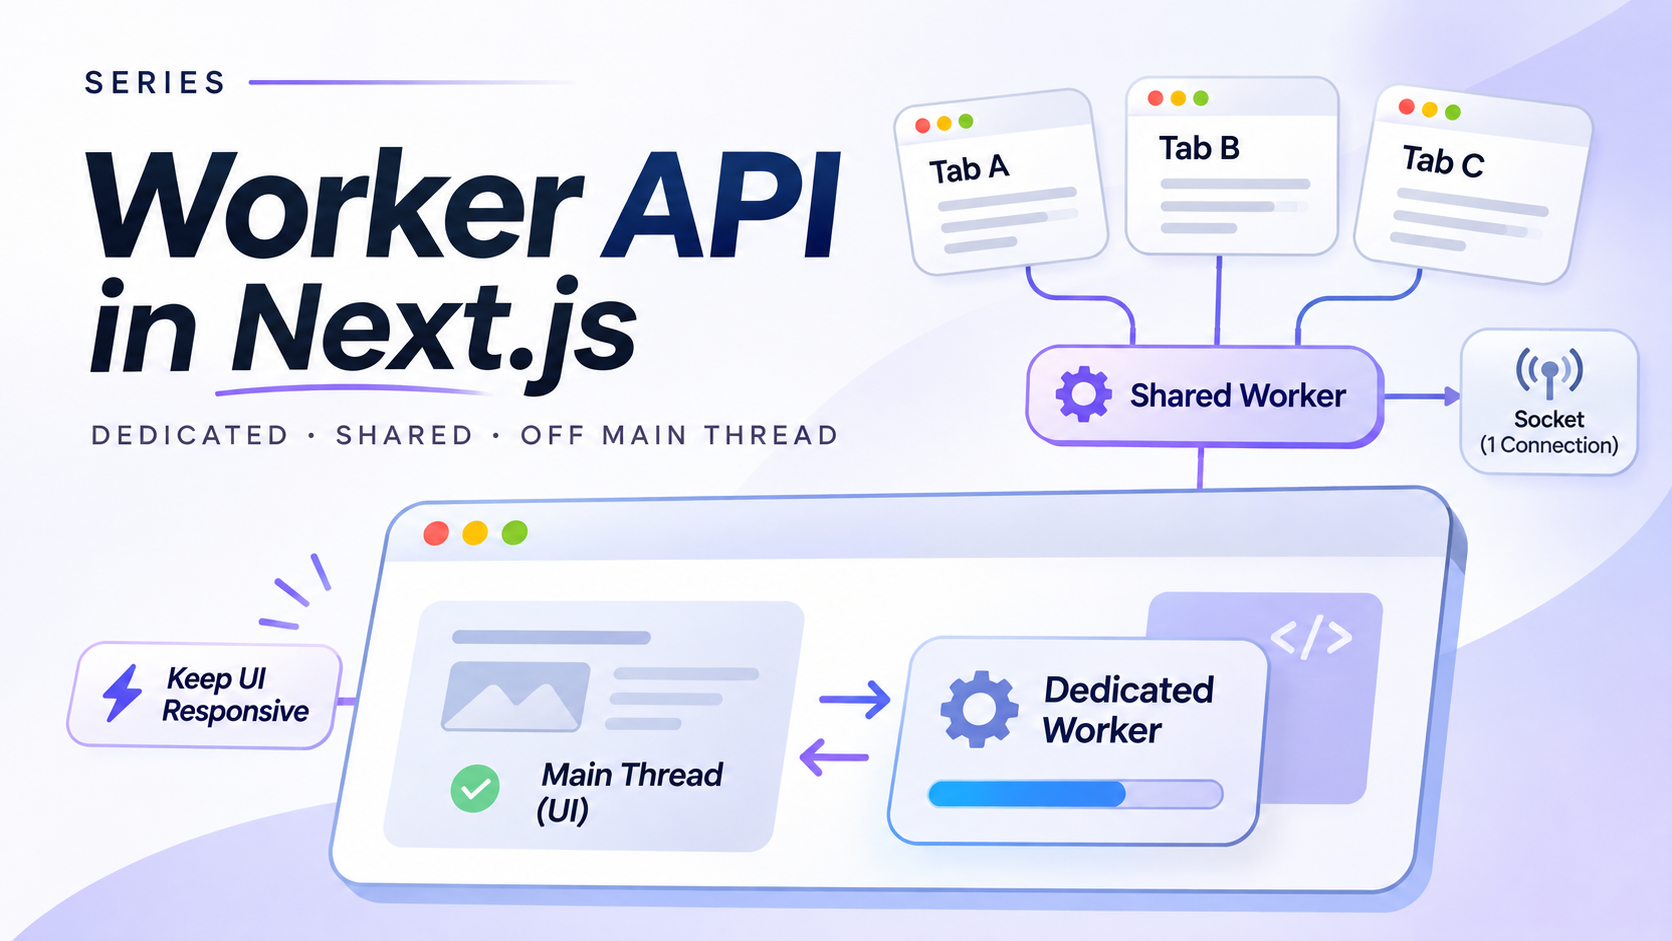
이미지 하나를 처리했을 뿐인데 버튼 hover가 끊기고 입력창이 늦게 반응할 때가 있다. 이런 상황을 만나면 React 렌더링이나 상태 업데이트부터 의심하기 쉽지만, 실제 문제는 훨씬 단순할 수 있다. 사용자의 입력을 처리하고, JavaScript를 실행하고, 다음 화면을 그릴 준비를 하는 일이 같은 메인 스레드 위에서 경쟁하고 있는 것이다.
Next.js가 서버 컴포넌트를 사용한다고 해서 브라우저의 메인 스레드가 사라지는 것은 아니다. 클라이언트 컴포넌트에서 큰 배열을 정렬하거나 이미지 픽셀을 순회하면 그 계산은 여전히 사용자의 입력과 렌더링 기회를 밀어낸다. 이때 확인할 것은 계산의 실행 위치다.
async로 바꿨는데도 화면은 왜 멈췄나
async/await는 Promise 기반 비동기 작업의 순서를 표현한다. 계산의 실행 위치는 바꾸지 않는다. 브라우저가 네트워크나 타이머 같은 작업을 맡아주는 동안에는 메인 스레드가 다른 일을 처리하지만, JavaScript가 직접 수행해야 하는 긴 반복문은 함수에 async를 붙여도 같은 스레드에서 실행된다.
아래 함수는 Promise를 반환하지만 expensiveTransform은 첫 번째 await를 만나기 전에 동기적으로 끝까지 실행된다. 그동안 입력 이벤트와 렌더링은 기다려야 한다.
async function handleLargePayload(payload: number[]) { const result = expensiveTransform(payload); await saveResult(result);}function expensiveTransform(payload: number[]) { return payload.map((value) => { let next = value; for (let index = 0; index < 50_000; index += 1) { next = (next * 17 + index) % 9_973; } return next; });}saveResult를 기다리는 동안에는 브라우저가 다른 일을 처리한다. 그 앞의 계산은 이미 메인 스레드를 점유했다. Worker는 이 계산이 실행되는 컨텍스트를 바꾼다.
기다리는 작업과 계산하는 작업은 다르다
네트워크 응답을 기다리는 작업과 이미 받은 데이터를 계산하는 작업은 겉으로는 둘 다 “오래 걸린다”. 하지만 메인 스레드 관점에서는 전혀 다르다. 전자는 브라우저나 운영체제에 일을 맡긴 뒤 결과를 기다릴 수 있고, 후자는 JavaScript 엔진이 직접 명령을 실행해야 한다.
물론 CPU 작업도 잘게 나누어 이벤트 루프에 기회를 돌려줄 수 있다. 다만 이것은 계산을 병렬로 옮기는 것과 다르다. 작업을 나누는 비용과 상태 관리가 생기고, microtask만 연달아 예약하면 브라우저가 렌더링할 기회를 충분히 얻지 못할 수도 있다. 긴 계산을 실제로 다른 실행 컨텍스트에서 처리하려면 Worker를 검토해야 한다.
CPU 작업이라고 모두 Worker로 보낼 이유는 없다. 2ms짜리 계산을 위해 데이터를 복사하고 메시지를 왕복하면 부대 비용이 더 커진다. Worker의 이득은 계산 시간과 데이터 이동 비용을 함께 잴 때 보인다.
Worker는 계산과 함께 경계를 만든다
Dedicated Worker는 별도의 전역 실행 환경에서 코드를 실행한다. 그 안에서는 DOM과 Window에 직접 접근할 수 없고 React state도 바꿀 수 없다. 메인 스레드는 작업을 메시지로 요청하고, Worker는 결과를 메시지로 돌려준다.
이 제약은 귀찮지만 유용하다. Worker에 보낼 수 있도록 작업을 정리하다 보면 입력과 출력이 분명해지고, 화면 코드와 계산 코드가 자연스럽게 갈라진다. 반대로 DOM을 계속 읽어야 하거나 계산 중간마다 UI를 직접 바꿔야 하는 작업이라면 Worker로 옮기기 어렵다. 결국 Worker는 작업의 입력과 출력을 강제로 드러낸다.
일반 객체는 두 컨텍스트 사이에서 참조를 그대로 공유하지 않는다. postMessage가 지원하는 값은 structured clone 알고리즘으로 복제되고, 함수나 DOM 노드처럼 복제할 수 없는 값은 DataCloneError를 만들 수 있다. SharedArrayBuffer와 Atomics를 사용하는 명시적 공유 메모리 모델은 예외지만, 일반적인 Worker 메시지 흐름과는 별도로 다뤄야 한다.
계산을 옮기면 데이터도 옮겨야 한다
작은 명령 객체나 숫자 하나는 메시지 비용이 크게 드러나지 않는다. 반면 이미지 데이터나 큰 ArrayBuffer를 왕복하면 복사 비용이 계산 시간만큼 커질 수 있다. 이때 사용할 수 있는 선택지가 transferable object다.
아래 코드는 8MB 버퍼의 소유권을 Worker로 이전한다. 두 번째 인자에 버퍼를 넣으면 같은 내용을 복제하는 대신 기반 메모리를 받는 쪽으로 옮긴다.
const bytes = new Uint8Array(1024 * 1024 * 8);worker.postMessage( { type: 'process-buffer', buffer: bytes.buffer }, [bytes.buffer],);전송이 끝나면 메인 스레드의 bytes.buffer는 detach된다. 소유권은 한쪽에서 다른 쪽으로 이동하고, 계산이 끝나면 결과 버퍼가 다시 돌아온다. 복사 비용을 줄이는 대신 소유권이 더 명확해지는 셈이다.
structured clone과 transfer 중 무엇이 나은지는 데이터 크기와 재사용 방식에 따라 달라진다. 작은 값은 복사가 단순하고, 큰 바이너리 데이터는 transfer가 유리할 가능성이 높다. 다만 “가능성이 높다”와 “실제로 빨라졌다”는 다른 말이다. Performance 패널과 실제 기기에서 확인해야 한다.
내 작업은 Worker 후보인가
나는 다음 질문을 통과한 작업만 Worker 후보로 본다.
- 사용자가 입력하거나 화면이 갱신되는 동안에도 계산을 계속해야 하는가?
- Performance 패널에서 메인 스레드의 긴 작업으로 관찰되는가?
- DOM 접근 없이 입력과 출력이 있는 작업으로 분리할 수 있는가?
- 데이터 이동 비용보다 계산량이 충분히 큰가?
- 오류, 취소, 오래된 응답을 메시지 프로토콜로 관리할 가치가 있는가?
- 이 작업은 한 화면만 소유하는가, 아니면 여러 탭이 함께 써야 하는가?
마지막 질문은 Worker의 종류를 가른다. 한 화면의 계산이라면 Dedicated Worker가 자연스럽다. 여러 탭이 하나의 연결이나 상태를 공유한다면 SharedWorker를 검토한다. API 이름을 고르기 전에 작업과 데이터와 자원을 어느 실행 컨텍스트가 소유할지 정해야 한다.
댓글
댓글을 불러오는 중...